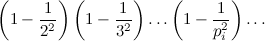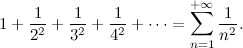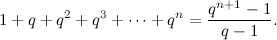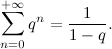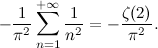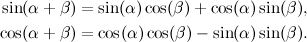domenica 25 dicembre 2011
Il teorema di Gödel senza parole
P(z) è una formula che parla di formule utilizzando numeri.
P(G(P(z))) è una formula che parla della formula che corrisponde a G(P(z)), cioè sé stessa. Affermando di essere indimostrabile. Quindi vera.
Le altre parole sono qua.
venerdì 9 dicembre 2011
Sigma
In attesa del seminario del 13 dicembre, che dovrebbe dirci qualcosa di più sul bosone di Higgs, eminenti fisici ci hanno spiegato come interpretare i risultati. Sia Amedeo Balbi che Peppe Liberti hanno parlato di significatività statistica, e Marco Delmastro ha promesso che cercherà di commentare in diretta i risultati (connessione permettendo).
Il numerino da controllare, quando arriverà la comunicazione ufficiale, sarà il famoso (per chi ha letto gli articoli linkati qua sopra) numero di sigma. Dice la teoria che il valore vero ha circa il 68% di probabilità di essere compreso in un intervallo di più o meno un sigma attorno alla media dei dati. La domanda è: perché proprio il 68%? Da dove salta fuori questo numero?
Tutto nasce dai cosiddetti teoremi del limite centrale: essi dicono che la somma di un grande numero di variabili casuali ha una distribuzione ben nota, detta appunto normale, o standard. Questo significa, in pratica, che le misure effettuate potranno essere affette da errori accidentali, ma tutti questi errori riescono, in un certo senso, a compensarsi un po'.
Facciamo un esempio: il lancio di un dado.
Il risultato ottenuto lanciando un dado (a 6 facce) è una variabile casuale: se il dado non è truccato io non posso prevedere quale numero uscirà. Ma se lo lancio tante volte, so che le sue facce si presenteranno tutte con una probabilità pari a 1/6. Questo in teoria, perché il dado non ha memoria dei lanci precedenti e, quindi, non rispetterà alla lettera questa regola.
Se io lancio molte volte un dado, e faccio il rapporto tra il numero di volte in cui è uscito un certo numero (diciamo il numero 1) e il numero di lanci totali, mi aspetto che all'aumentare del numero dei lanci questo rapporto si avvicini al valore teorico di 1/6. Più lanci faccio, migliore sarà questa approssimazione.
Ecco un primo esperimento: un dado viene lanciato 1000 volte, e viene calcolato il rapporto tra numero di volte in cui è uscito 1 e numero di lanci totali (cioè 1000). Questa prova è stata ripetuta per mille volte (l'ha fatto il computer, eh), e i mille risultati sono stati rappresentati su questo grafico:
Come si può vedere, i valori si accumulano intorno al valore teorico di 1/6, cioè 1.(6). L'istogramma sembra avere una forma abbastanza regolare, ma siamo ancora molto lontani dalla curva teorica.
In questo secondo esperimento il dado viene lanciato 10000 volte. Ancora una volta la prova è stata ripetuta per mille volte, ed ecco il nuovo grafico:
I dati sono distribuiti in un intervallo più stretto, e la forma appare più regolare.
Un ultimo esperimento: 20000 lanci, e ancora mille ripetizioni. Ecco il grafico:
Leggermente più stretto del precedente, e ancora più regolare.
Ecco un altro grafico in cui i tre precedenti sono rappresentati contemporaneamente, per poterne apprezzare le differenze:
La teoria ci dice che la curva a cui questi istogrammi cercano di assomigliare, detta curva gaussiana, ha la seguente forma base: y = e-x2. Ed ecco il suo grafico:
Il valore di sigma ha un significato geometrico: è l'ascissa del punto di flesso di destra (mentre sigma cambiato di segno è naturalmente l'ascissa del punto di flesso di sinistra). Dunque un valore compreso in un intervallo di ampiezza sigma attorno al valore medio si trova nella zona evidenziata da questo grafico:
Conoscere la probabilità di essere nella zona delimitata dalle due rette rosse significa conoscere il rapporto tra l'area della curva compresa nella suddetta zona e l'area totale. Questo non è un numero facile da calcolare, perché per calcolare le aree ci servirebbero gli integrali, ma l'integrale della gaussiana è difficilmente trattabile. Riusciamo a calcolare in maniera esatta soltanto l'area compresa sotto tutta la curva (che, in teoria, si estende all'infinito sia a destra che a sinistra), ma non riusciamo a calcolare l'area di una sua generica parte.
E allora ci affidiamo al computer, che ci dice che l'area che stiamo cercando è il 68.3%. Se allarghiamo la zona rossa, andando da -2σ a +2σ, otteniamo un'area pari a circa il 95.5% del totale. Con 3σ siamo al 99.7%. Ed ecco fatto.
Dimenticavo un'ultima cosa: l'area totale compresa dalla gaussiana e l'asse delle ascisse è uguale alla radice quadrata di pi greco, questo per confermare la prezzemolosità del nostro amico π.
[Edit: Marco Delmastro ha iniziato a parlare di statistica, e lo fa lanciando dei dadi. Dategli un'occhiata…]
Il numerino da controllare, quando arriverà la comunicazione ufficiale, sarà il famoso (per chi ha letto gli articoli linkati qua sopra) numero di sigma. Dice la teoria che il valore vero ha circa il 68% di probabilità di essere compreso in un intervallo di più o meno un sigma attorno alla media dei dati. La domanda è: perché proprio il 68%? Da dove salta fuori questo numero?
Tutto nasce dai cosiddetti teoremi del limite centrale: essi dicono che la somma di un grande numero di variabili casuali ha una distribuzione ben nota, detta appunto normale, o standard. Questo significa, in pratica, che le misure effettuate potranno essere affette da errori accidentali, ma tutti questi errori riescono, in un certo senso, a compensarsi un po'.
Facciamo un esempio: il lancio di un dado.
Il risultato ottenuto lanciando un dado (a 6 facce) è una variabile casuale: se il dado non è truccato io non posso prevedere quale numero uscirà. Ma se lo lancio tante volte, so che le sue facce si presenteranno tutte con una probabilità pari a 1/6. Questo in teoria, perché il dado non ha memoria dei lanci precedenti e, quindi, non rispetterà alla lettera questa regola.
Se io lancio molte volte un dado, e faccio il rapporto tra il numero di volte in cui è uscito un certo numero (diciamo il numero 1) e il numero di lanci totali, mi aspetto che all'aumentare del numero dei lanci questo rapporto si avvicini al valore teorico di 1/6. Più lanci faccio, migliore sarà questa approssimazione.
Ecco un primo esperimento: un dado viene lanciato 1000 volte, e viene calcolato il rapporto tra numero di volte in cui è uscito 1 e numero di lanci totali (cioè 1000). Questa prova è stata ripetuta per mille volte (l'ha fatto il computer, eh), e i mille risultati sono stati rappresentati su questo grafico:
Come si può vedere, i valori si accumulano intorno al valore teorico di 1/6, cioè 1.(6). L'istogramma sembra avere una forma abbastanza regolare, ma siamo ancora molto lontani dalla curva teorica.
In questo secondo esperimento il dado viene lanciato 10000 volte. Ancora una volta la prova è stata ripetuta per mille volte, ed ecco il nuovo grafico:
I dati sono distribuiti in un intervallo più stretto, e la forma appare più regolare.
Un ultimo esperimento: 20000 lanci, e ancora mille ripetizioni. Ecco il grafico:
Leggermente più stretto del precedente, e ancora più regolare.
Ecco un altro grafico in cui i tre precedenti sono rappresentati contemporaneamente, per poterne apprezzare le differenze:
La teoria ci dice che la curva a cui questi istogrammi cercano di assomigliare, detta curva gaussiana, ha la seguente forma base: y = e-x2. Ed ecco il suo grafico:
Il valore di sigma ha un significato geometrico: è l'ascissa del punto di flesso di destra (mentre sigma cambiato di segno è naturalmente l'ascissa del punto di flesso di sinistra). Dunque un valore compreso in un intervallo di ampiezza sigma attorno al valore medio si trova nella zona evidenziata da questo grafico:
Conoscere la probabilità di essere nella zona delimitata dalle due rette rosse significa conoscere il rapporto tra l'area della curva compresa nella suddetta zona e l'area totale. Questo non è un numero facile da calcolare, perché per calcolare le aree ci servirebbero gli integrali, ma l'integrale della gaussiana è difficilmente trattabile. Riusciamo a calcolare in maniera esatta soltanto l'area compresa sotto tutta la curva (che, in teoria, si estende all'infinito sia a destra che a sinistra), ma non riusciamo a calcolare l'area di una sua generica parte.
E allora ci affidiamo al computer, che ci dice che l'area che stiamo cercando è il 68.3%. Se allarghiamo la zona rossa, andando da -2σ a +2σ, otteniamo un'area pari a circa il 95.5% del totale. Con 3σ siamo al 99.7%. Ed ecco fatto.
Dimenticavo un'ultima cosa: l'area totale compresa dalla gaussiana e l'asse delle ascisse è uguale alla radice quadrata di pi greco, questo per confermare la prezzemolosità del nostro amico π.
[Edit: Marco Delmastro ha iniziato a parlare di statistica, e lo fa lanciando dei dadi. Dategli un'occhiata…]
martedì 6 dicembre 2011
Come il prezzemolo
«Se ti dico pi greco (o pi greca, come fanno gli snob), a cosa pensi?».
«A una circonferenza».
«Bene. È affascinante scoprire che π non salta fuori solo quando si parla di circonferenze».
«Per esempio?».
«Per esempio, può essere nascosto anche in domande innocenti riguardanti la probabilità, che mai farebbero pensare alle circonferenze».
«E cioè?».
«E cioè: qual è la probabilità che due numeri interi scelti a caso siano primi tra loro?».
«Boh?».
«Partiamo da un esempio finito. Consideriamo i numeri da 1 a 30».
«Bene».
«Quanti sono i numeri primi tra loro?».
«Non lo so, dobbiamo contarli?».
«Sì, in modo da ricavare una regola. Cominciamo osservando che 30 è uguale al prodotto di 2 per 3 per 5».
«Vero».
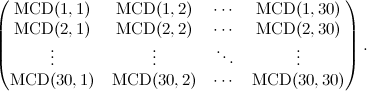
«Allora, costruiamo una matrice in cui inseriamo, nella riga i e nella colonna j, il Massimo Comun Divisore tra i e j, dove i e j sono numeri che variano da 1 fino a 30».
«Uhm, non so se ho capito bene».
«Ecco qua la matrice:».
«Che brutta».
«Eh, porta pazienza. Allora, quanti elementi contiene?».
«900».
«Bene. Quanti sono quelli multipli di 2?».
«Mh, direi tutti quelli per cui sia i che j sono numeri pari».
«Esatto. Dato che i e j rappresentano anche le righe e le colonne della matrice, possiamo dire che sono tutti i numeri che si trovano in una riga e in una colonna di indice pari».
«Ok. Ma allora possiamo dire che sono un quarto di tutti i numeri, perché gli elementi che stanno su una riga e una colonna pari sono un quarto del totale degli elementi».
«Esatto. Ci restano allora da esaminare 900(1-1/4) elementi».
«Cioè 675».
«Ora, quanti sono, tra questi 675, quelli che sono multipli di 3?».
«Uh, comincia a diventare difficile. Vediamo, sono i numeri che si trovano su una riga multipla di tre e anche su una colonna multipla di tre».
«Sì, vedi che non è difficile?».
«Ma non capisco come fare quando trovo sia numeri multipli di 2 che multipli di 3. Per esempio, quando arrivo a MCD(6,12), cosa succede?».
«Ricordati che i multipli di 2 li abbiamo eliminati, non dobbiamo più considerarli. Stiamo adesso analizzando i 675 numeri rimasti, quindi è come se avessimo tolto le posizioni in cui ci sono i multipli di 2».
«Ah, giusto. Allora mi pare che i multipli di 3 siano 1/9 del totale».
«Perché?».
«Perché si trovano in una posizione ogni 3 di una colonna ogni 3 (o di una riga ogni 3)».
«Perfetto. Quindi se eliminiamo anche questi multipli rimaniamo con 900(1-1/4)(1-1/9) = 600 numeri».
«Bene. Ora guardiamo i multipli di 5?».
«Ci sarebbero prima i multipli di 4, ma quelli sono già andati via quando abbiamo tolto i multipli di 2».
«Giusto».
«Allora, dei 600 numeri rimasti, quanti sono quelli multipli di 5?».
«Uno ogni 5 una riga ogni 5 (o una colonna ogni 5)».
«Quindi ci rimangono 900(1-1/4)(1-1/9)(1-1/25) = 576 numeri».
«E allora?».
«Allora nella matrice abbiamo 576 numeri uguali a 1 oppure coprimi con 2, 3 e 5».
«Giusto».
«Adesso generalizziamo, e passiamo a una matrice infinita».
«Uhm».
«Immaginiamo di non fermarci a n = 30, ma vediamo che succede quando n diventa sempre più grande».
«Potremo continuare a eliminare multipli finché vogliamo».
«Certo, secondo una legge che abbiamo intuito».
«Sarebbe questa: n(1-1/4)(1-1/9)(1-1/25)…».
«Sì. Ricordati che i denominatori di quelle frazioni sono i quadrati dei numeri primi, quindi dopo la parentesi (1-1/25) avrai (1-1/49)».
«Ok».
«Allora, quando n diventa sempre più grande, il rapporto tra i valori uguali a 1 nella matrice e il totale dei valori diventerà sempre più vicino a questa espressione:».
«Dove pi è un numero primo».
«Esatto. Adesso consideriamo un fattore generico di questo prodotto».
«Una delle tante parentesi del tipo:».
«Esatto. Fai il reciproco».
«Vediamo, prima faccio il denominatore comune, poi capovolgo. Ecco:».
«Benissimo. Se io divido numeratore e denominatore per il quadrato di pi, ottengo:».
«Che orrore! Perché l'hai scritto così?».
«Non ti ricorda niente?».
«Ah! Ma è il risultato della serie geometrica!».
«Proprio quello. Quindi ognuno di quei fattori può essere scritto come serie geometrica, in questo modo:».
«Mamma mia che roba. Abbiamo trasformato un prodotto di infinite parentesi in un prodotto di infinite serie geometriche».
«Nel reciproco di un prodotto di infinite serie geometriche. E adesso lo calcoliamo».
«Ma dai…».
«Dico davvero. Se applichiamo a quel prodotto la proprietà distributiva…».
«Ma si può?».
«No».
«E allora?».
«E allora facciamo finta che si possa. I Veri Matematici hanno dimostrato che tutti questi passaggi hanno senso, e allora noi ci fidiamo e vediamo di intuire dove si va a finire, lasciando a loro i tediosi calcoli intermedi».
«Mi piace questo metodo».
«Quindi, attenzione: se svolgiamo tutti quei prodotti tra le varie serie geometriche, cosa otteniamo?».
«Un sacco di roba».
«Cominciamo: certamente otteniamo 1».
«Ok, il prodotto di tutti gli 1 che sono al primo posto nelle parentesi».
«Poi otteniamo delle frazioni del tipo 1/p2, per ogni numero primo p».
«Giusto».
«Poi frazioni del tipo 1/p4, 1/p6, eccetera».
«Ho capito: andando avanti le frazioni si complicano, e al denominatore potrò avere tutte le possibili combinazioni dei quadrati dei numeri primi».
«Esatto, ma non solo quadrati: qualunque potenza di quei quadrati».
«Perfetto, ci sono».
«E quindi, prima o poi ogni numero naturale comparirà, elevato al quadrato, al denominatore».
«Sicuramente, ogni numero naturale è scomponibile in fattori primi. Quindi prima o poi compariranno tutti: ho capito».
«Benissimo. Allora ti riordino i risultati che troveremo:».
«Ma no! Quella inutile formula che mi hai spiegato qualche giorno fa».
«VUOI SMETTERLA?».
«Scusa».
«Quanto risultava, quella importantissima formula?».
«Eh, risultava π2/6».
«E allora, riassumendo, la probabilità che in quella matrice ci siano degli 1 è il reciproco di questo numero».
«Quindi la probabilità che due numeri scelti a caso siano primi tra loro è 6/π2. Incredibile».
«Davvero incredibile. Per arrivare al risultato siamo passati attraverso i numeri primi, la serie di Taylor del seno, la serie geometrica, gli infiniti, la funzione zeta di Eulero».
«E abbiamo trovato pi greco».
«A una circonferenza».
«Bene. È affascinante scoprire che π non salta fuori solo quando si parla di circonferenze».
«Per esempio?».
«Per esempio, può essere nascosto anche in domande innocenti riguardanti la probabilità, che mai farebbero pensare alle circonferenze».
«E cioè?».
«E cioè: qual è la probabilità che due numeri interi scelti a caso siano primi tra loro?».
«Boh?».
«Partiamo da un esempio finito. Consideriamo i numeri da 1 a 30».
«Quanti sono i numeri primi tra loro?».
«Non lo so, dobbiamo contarli?».
«Sì, in modo da ricavare una regola. Cominciamo osservando che 30 è uguale al prodotto di 2 per 3 per 5».
«Vero».
«Allora, costruiamo una matrice in cui inseriamo, nella riga i e nella colonna j, il Massimo Comun Divisore tra i e j, dove i e j sono numeri che variano da 1 fino a 30».
«Uhm, non so se ho capito bene».
«Ecco qua la matrice:».
«Che brutta».
«Eh, porta pazienza. Allora, quanti elementi contiene?».
«900».
«Bene. Quanti sono quelli multipli di 2?».
«Mh, direi tutti quelli per cui sia i che j sono numeri pari».
«Esatto. Dato che i e j rappresentano anche le righe e le colonne della matrice, possiamo dire che sono tutti i numeri che si trovano in una riga e in una colonna di indice pari».
«Ok. Ma allora possiamo dire che sono un quarto di tutti i numeri, perché gli elementi che stanno su una riga e una colonna pari sono un quarto del totale degli elementi».
«Esatto. Ci restano allora da esaminare 900(1-1/4) elementi».
«Cioè 675».
«Ora, quanti sono, tra questi 675, quelli che sono multipli di 3?».
«Uh, comincia a diventare difficile. Vediamo, sono i numeri che si trovano su una riga multipla di tre e anche su una colonna multipla di tre».
«Sì, vedi che non è difficile?».
«Ma non capisco come fare quando trovo sia numeri multipli di 2 che multipli di 3. Per esempio, quando arrivo a MCD(6,12), cosa succede?».
«Ricordati che i multipli di 2 li abbiamo eliminati, non dobbiamo più considerarli. Stiamo adesso analizzando i 675 numeri rimasti, quindi è come se avessimo tolto le posizioni in cui ci sono i multipli di 2».
«Ah, giusto. Allora mi pare che i multipli di 3 siano 1/9 del totale».
«Perché?».
«Perché si trovano in una posizione ogni 3 di una colonna ogni 3 (o di una riga ogni 3)».
«Perfetto. Quindi se eliminiamo anche questi multipli rimaniamo con 900(1-1/4)(1-1/9) = 600 numeri».
«Bene. Ora guardiamo i multipli di 5?».
«Ci sarebbero prima i multipli di 4, ma quelli sono già andati via quando abbiamo tolto i multipli di 2».
«Giusto».
«Allora, dei 600 numeri rimasti, quanti sono quelli multipli di 5?».
«Uno ogni 5 una riga ogni 5 (o una colonna ogni 5)».
«Quindi ci rimangono 900(1-1/4)(1-1/9)(1-1/25) = 576 numeri».
«E allora?».
«Allora nella matrice abbiamo 576 numeri uguali a 1 oppure coprimi con 2, 3 e 5».
«Giusto».
«Adesso generalizziamo, e passiamo a una matrice infinita».
«Uhm».
«Immaginiamo di non fermarci a n = 30, ma vediamo che succede quando n diventa sempre più grande».
«Potremo continuare a eliminare multipli finché vogliamo».
«Certo, secondo una legge che abbiamo intuito».
«Sarebbe questa: n(1-1/4)(1-1/9)(1-1/25)…».
«Sì. Ricordati che i denominatori di quelle frazioni sono i quadrati dei numeri primi, quindi dopo la parentesi (1-1/25) avrai (1-1/49)».
«Ok».
«Allora, quando n diventa sempre più grande, il rapporto tra i valori uguali a 1 nella matrice e il totale dei valori diventerà sempre più vicino a questa espressione:».
«Dove pi è un numero primo».
«Esatto. Adesso consideriamo un fattore generico di questo prodotto».
«Una delle tante parentesi del tipo:».
«Esatto. Fai il reciproco».
«Vediamo, prima faccio il denominatore comune, poi capovolgo. Ecco:».
«Benissimo. Se io divido numeratore e denominatore per il quadrato di pi, ottengo:».
«Che orrore! Perché l'hai scritto così?».
«Non ti ricorda niente?».
«Ah! Ma è il risultato della serie geometrica!».
«Proprio quello. Quindi ognuno di quei fattori può essere scritto come serie geometrica, in questo modo:».
«Mamma mia che roba. Abbiamo trasformato un prodotto di infinite parentesi in un prodotto di infinite serie geometriche».
«Nel reciproco di un prodotto di infinite serie geometriche. E adesso lo calcoliamo».
«Ma dai…».
«Dico davvero. Se applichiamo a quel prodotto la proprietà distributiva…».
«Ma si può?».
«No».
«E allora?».
«E allora facciamo finta che si possa. I Veri Matematici hanno dimostrato che tutti questi passaggi hanno senso, e allora noi ci fidiamo e vediamo di intuire dove si va a finire, lasciando a loro i tediosi calcoli intermedi».
«Mi piace questo metodo».
«Quindi, attenzione: se svolgiamo tutti quei prodotti tra le varie serie geometriche, cosa otteniamo?».
«Un sacco di roba».
«Cominciamo: certamente otteniamo 1».
«Ok, il prodotto di tutti gli 1 che sono al primo posto nelle parentesi».
«Poi otteniamo delle frazioni del tipo 1/p2, per ogni numero primo p».
«Giusto».
«Poi frazioni del tipo 1/p4, 1/p6, eccetera».
«Ho capito: andando avanti le frazioni si complicano, e al denominatore potrò avere tutte le possibili combinazioni dei quadrati dei numeri primi».
«Esatto, ma non solo quadrati: qualunque potenza di quei quadrati».
«Perfetto, ci sono».
«E quindi, prima o poi ogni numero naturale comparirà, elevato al quadrato, al denominatore».
«Sicuramente, ogni numero naturale è scomponibile in fattori primi. Quindi prima o poi compariranno tutti: ho capito».
«Benissimo. Allora ti riordino i risultati che troveremo:».
«Ma no! Quella inutile formula che mi hai spiegato qualche giorno fa».
«VUOI SMETTERLA?».
«Scusa».
«Quanto risultava, quella importantissima formula?».
«Eh, risultava π2/6».
«E allora, riassumendo, la probabilità che in quella matrice ci siano degli 1 è il reciproco di questo numero».
«Quindi la probabilità che due numeri scelti a caso siano primi tra loro è 6/π2. Incredibile».
«Davvero incredibile. Per arrivare al risultato siamo passati attraverso i numeri primi, la serie di Taylor del seno, la serie geometrica, gli infiniti, la funzione zeta di Eulero».
«E abbiamo trovato pi greco».
lunedì 5 dicembre 2011
Senso fisico un po' scarsino
«Ehi, cosa stai facendo con quella valvola del termosifone?».
«Eh, prof, la sto riattaccando!».
«Ma perché la staccate?».
«Prof, stamattina quando siamo entrati c'era freddissimo, e allora l'abbiamo staccata per scaldare un po'».
«Scusate, ma sono valvole elettriche, c'è l'impianto che regola la temperatura».
«Ma stamattina c'era troppo freddo, ho staccato la valvola e in un secondo il termo è diventato caldissimo. L'impianto fa schifo».
«E adesso c'è troppo caldo».
«Infatti, sto riattaccando la valvola così si raffredda un po'».
(passano cinque secondi)
«Prof, ma non diventa freddo, come mai?».
«Scusa, e tu pensi che un termo lungo due metri diventi freddo in cinque secondi?».
«Oh, prof, stamattina appena ho staccato la valvola e ha iniziato a girare l'acqua, si è scaldato in un attimo. Non capisco perché adesso fa così».
«Scusa ma, adesso, dato che è stata chiusa la valvola, cosa dovrebbe succedere?».
«Mh. Non passa acqua fredda, vero?».
«Se la valvola chiude, tu cosa dici?».
«Allora forse devo aspettare che si raffreddi?».
Istituto tecnico. Industriale. Classe quinta.
«Eh, prof, la sto riattaccando!».
«Ma perché la staccate?».
«Prof, stamattina quando siamo entrati c'era freddissimo, e allora l'abbiamo staccata per scaldare un po'».
«Scusate, ma sono valvole elettriche, c'è l'impianto che regola la temperatura».
«Ma stamattina c'era troppo freddo, ho staccato la valvola e in un secondo il termo è diventato caldissimo. L'impianto fa schifo».
«E adesso c'è troppo caldo».
«Infatti, sto riattaccando la valvola così si raffredda un po'».
(passano cinque secondi)
«Prof, ma non diventa freddo, come mai?».
«Scusa, e tu pensi che un termo lungo due metri diventi freddo in cinque secondi?».
«Oh, prof, stamattina appena ho staccato la valvola e ha iniziato a girare l'acqua, si è scaldato in un attimo. Non capisco perché adesso fa così».
«Scusa ma, adesso, dato che è stata chiusa la valvola, cosa dovrebbe succedere?».
«Mh. Non passa acqua fredda, vero?».
«Se la valvola chiude, tu cosa dici?».
«Allora forse devo aspettare che si raffreddi?».
Istituto tecnico. Industriale. Classe quinta.
La serie geometrica
«Qual è la frazione generatrice di un numero decimale periodico?».
«Eeh?».
«A cosa è uguale zero virgola tre periodico?».
«A un terzo».
«Perché?».
«Perché sì, è vero!».
«Ottimo esempio di dimostrazione…».
«È vero o no che 1/3 è uguale a 0.(3)?».
«Certo, ma volevo sapere se sai cosa c'è sotto».
«Veramente no».
«C'è una formuletta interessante, che riguarda la serie geometrica».
«Uhm».
«La serie geometrica è questa cosina qui:».
«Una somma infinita. Ha senso?».
«A volte sì».
«Come, a volte? Come è possibile?».
«Cominciamo dal caso finito: se n è un numero naturale, quella somma diventa uguale a:».
1 + q + q2 + q3 + … + qn.
«Ok».
«Ora troviamo una espressione più semplice».
«Non va bene quella?».
«Non tanto: ci danno molto fastidio i puntini».
«E perché?».
«Perché se vogliamo capire cosa succede quando n diventa sempre più grande, quella somma diventa una espressione infinitamente lunga, e non sappiamo come gestirla».
«Quindi tu vorresti eliminare i puntini? Si può?».
«Sì. Alle superiori dovrebbero averti insegnato come si fanno le divisioni tra polinomi. Io confido nel fatto che tu le sappia ancora fare…».
«Ehm».
«Grazie alla regola della divisione tra polinomi, puoi verificare tu stesso questa uguaglianza:».
«Mh».
«Altrimenti ti fidi».
«Mi fido sulla parola senza problemi».
«Vabbé. Allora, vedi che la seconda espressione è più semplice della prima, anche se contiene una divisione».
«Sì, se ti danno tanto fastidio i puntini, la seconda espressione non ne ha».
«Prova allora a pensare a cosa succede man mano che n diventa sempre più grande».
«Quel numeratore diventerà sempre più grande, dato che è elevato alla n+1».
«Siamo sicuri?».
«Certo, se elevo un numero a potenza questo aumenta».
«Prova a elevare un mezzo».
«Un quarto. Oops. Ehm».
«Fai una osservazione intelligente».
«Se elevo alla n un numero maggiore di 1, allora ottengo un risultato maggiore del numero di partenza. Altrimenti il risultato è minore».
«Prova a prendere -2, che è sicuramente minore di 1».
«Risulta 4. Uffa. Allora: se elevo alla n un numero maggiore di 1 oppure minore di -1, ottengo un risultato maggiore, altrimenti è minore».
«Calcola -2 elevato alla 3».
«Fa -8, argh, è minore. Ma quanti casi ci sono?».
«Se vuoi semplificare un po' il numero di casi, devi usare il valore assoluto. Se elevi alla n un numero in valore assoluto maggiore di 1, ottieni un numero che, in valore assoluto, è maggiore. Se elevi invece alla n un numero in valore assoluto minore di 1, allora ottieni un numero che, sempre in valore assoluto, è minore di quello di partenza».
«Ho capito. Mi pare che tu abbia lasciato fuori 1 e -1».
«Sì, è vero. Se q = 1, la formula che ti ho scritto prima non vale».
«Perché?».
«Perché al denominatore risulterebbe zero».
«Ah, già. E allora?».
«Allora non la usiamo, ma non è difficile capire come stanno le cose. Se q = 1, la somma delle potenze di q diventa semplicemente una somma di tanti 1».
«Che aumenta sempre».
«Infatti. Se invece q = -1 la formula è valida, e il numeratore di quella frazione diventa alternativamente uguale a 0 oppure a -2».
«Una schifezza».
«Sì. Noi siamo interessati al caso di q minore di 1 in valore assoluto».
«Perché proprio quello?».
«Perché in quel caso, quando n diventa infinitamente grande, la potenza qn+1 diventa infinitamente piccola».
«E allora possiamo trascurarla, quando facciamo i calcoli?».
«Esatto. I Veri Matematici parlano di limite, c'è tutta una teoria sotto che motiva in modo preciso i vari passaggi, ma a noi interessa avere intuito il risultato».
«Che sarebbe questo?».
«Esatto. Quando q è, in valore assoluto, minore di 1, si dice che la serie geometrica converge, e il risultato viene chiamato somma della serie. Mentre q viene detto ragione della serie».
«Bello».
«E ora puoi calcolare quanto vale 0.(3)».
«Con la serie?».
«Sì».
«E come faccio?».
«Cosa significa zero virgola tre periodico?».
«Che ci sono infiniti 3 dopo la virgola».
«Che significato ha il primo di quei 3?».
«Uhm, boh, 3 decimi?».
«Esatto. E il secondo?».
«3 centesimi».
«E così via. Puoi quindi scrivere 0.(3) come una somma di tante frazioni:».
3/10 + 3/100 + 3/1000 + …
«Una serie geometrica?».
«Esatto».
«Ma non capisco quanto vale q».
«Te la scrivo in un altro modo:».
3/10 (1 + 1/10 + 1/100 + …).
«Ah, ho capito! La somma tra parentesi è la serie geometrica!».
«Di ragione?».
«Di ragione 1/10».
«Che è minore di 1, in valore assoluto. Quindi?».
«Quindi converge».
«A quale valore?».
«A 1/(1-1/10)».
«Cioè 1/(9/10), che è uguale a 10/9».
«E se adesso la moltiplico per il coefficiente 3/10, ottengo proprio 3/9, cioè 1/3. È la regolina che mi avevano insegnato alle medie per trovare la frazione generatrice di un numero decimale periodico, ora mi ricordo».
«Ottimo».
«Finalmente qualcosa di utile!».
«ALLORA?».
«Eeh?».
«A cosa è uguale zero virgola tre periodico?».
«A un terzo».
«Perché?».
«Perché sì, è vero!».
«Ottimo esempio di dimostrazione…».
«È vero o no che 1/3 è uguale a 0.(3)?».
«Certo, ma volevo sapere se sai cosa c'è sotto».
«Veramente no».
«C'è una formuletta interessante, che riguarda la serie geometrica».
«Uhm».
«La serie geometrica è questa cosina qui:».
«Una somma infinita. Ha senso?».
«A volte sì».
«Come, a volte? Come è possibile?».
«Cominciamo dal caso finito: se n è un numero naturale, quella somma diventa uguale a:».
1 + q + q2 + q3 + … + qn.
«Ok».
«Ora troviamo una espressione più semplice».
«Non va bene quella?».
«Non tanto: ci danno molto fastidio i puntini».
«E perché?».
«Perché se vogliamo capire cosa succede quando n diventa sempre più grande, quella somma diventa una espressione infinitamente lunga, e non sappiamo come gestirla».
«Quindi tu vorresti eliminare i puntini? Si può?».
«Sì. Alle superiori dovrebbero averti insegnato come si fanno le divisioni tra polinomi. Io confido nel fatto che tu le sappia ancora fare…».
«Ehm».
«Grazie alla regola della divisione tra polinomi, puoi verificare tu stesso questa uguaglianza:».
«Mh».
«Altrimenti ti fidi».
«Mi fido sulla parola senza problemi».
«Vabbé. Allora, vedi che la seconda espressione è più semplice della prima, anche se contiene una divisione».
«Sì, se ti danno tanto fastidio i puntini, la seconda espressione non ne ha».
«Prova allora a pensare a cosa succede man mano che n diventa sempre più grande».
«Quel numeratore diventerà sempre più grande, dato che è elevato alla n+1».
«Siamo sicuri?».
«Certo, se elevo un numero a potenza questo aumenta».
«Prova a elevare un mezzo».
«Un quarto. Oops. Ehm».
«Fai una osservazione intelligente».
«Se elevo alla n un numero maggiore di 1, allora ottengo un risultato maggiore del numero di partenza. Altrimenti il risultato è minore».
«Prova a prendere -2, che è sicuramente minore di 1».
«Risulta 4. Uffa. Allora: se elevo alla n un numero maggiore di 1 oppure minore di -1, ottengo un risultato maggiore, altrimenti è minore».
«Calcola -2 elevato alla 3».
«Fa -8, argh, è minore. Ma quanti casi ci sono?».
«Se vuoi semplificare un po' il numero di casi, devi usare il valore assoluto. Se elevi alla n un numero in valore assoluto maggiore di 1, ottieni un numero che, in valore assoluto, è maggiore. Se elevi invece alla n un numero in valore assoluto minore di 1, allora ottieni un numero che, sempre in valore assoluto, è minore di quello di partenza».
«Ho capito. Mi pare che tu abbia lasciato fuori 1 e -1».
«Sì, è vero. Se q = 1, la formula che ti ho scritto prima non vale».
«Perché?».
«Perché al denominatore risulterebbe zero».
«Ah, già. E allora?».
«Allora non la usiamo, ma non è difficile capire come stanno le cose. Se q = 1, la somma delle potenze di q diventa semplicemente una somma di tanti 1».
«Che aumenta sempre».
«Infatti. Se invece q = -1 la formula è valida, e il numeratore di quella frazione diventa alternativamente uguale a 0 oppure a -2».
«Una schifezza».
«Sì. Noi siamo interessati al caso di q minore di 1 in valore assoluto».
«Perché proprio quello?».
«Perché in quel caso, quando n diventa infinitamente grande, la potenza qn+1 diventa infinitamente piccola».
«E allora possiamo trascurarla, quando facciamo i calcoli?».
«Esatto. I Veri Matematici parlano di limite, c'è tutta una teoria sotto che motiva in modo preciso i vari passaggi, ma a noi interessa avere intuito il risultato».
«Che sarebbe questo?».
«Esatto. Quando q è, in valore assoluto, minore di 1, si dice che la serie geometrica converge, e il risultato viene chiamato somma della serie. Mentre q viene detto ragione della serie».
«Bello».
«E ora puoi calcolare quanto vale 0.(3)».
«Con la serie?».
«Sì».
«E come faccio?».
«Cosa significa zero virgola tre periodico?».
«Che ci sono infiniti 3 dopo la virgola».
«Che significato ha il primo di quei 3?».
«Uhm, boh, 3 decimi?».
«Esatto. E il secondo?».
«3 centesimi».
«E così via. Puoi quindi scrivere 0.(3) come una somma di tante frazioni:».
3/10 + 3/100 + 3/1000 + …
«Una serie geometrica?».
«Esatto».
«Ma non capisco quanto vale q».
«Te la scrivo in un altro modo:».
3/10 (1 + 1/10 + 1/100 + …).
«Ah, ho capito! La somma tra parentesi è la serie geometrica!».
«Di ragione?».
«Di ragione 1/10».
«Che è minore di 1, in valore assoluto. Quindi?».
«Quindi converge».
«A quale valore?».
«A 1/(1-1/10)».
«Cioè 1/(9/10), che è uguale a 10/9».
«E se adesso la moltiplico per il coefficiente 3/10, ottengo proprio 3/9, cioè 1/3. È la regolina che mi avevano insegnato alle medie per trovare la frazione generatrice di un numero decimale periodico, ora mi ricordo».
«Ottimo».
«Finalmente qualcosa di utile!».
«ALLORA?».
sabato 3 dicembre 2011
Il professor Apotema insegna: il calcolo delle differenze e il calcolo differenziale
Avevo già parlato dell'approccio assiomatico ai numeri iperreali e di come alcuni (pochi) insegnanti lo usino per spiegare l'analisi matematica.
Qualche giorno fa alcuni di questi insegnanti si sono ritrovati a Venezia, al liceo Foscarini, per una giornata di studio e confronto sull'analisi infinitesimale; tra questi c'era anche Giorgio Goldoni, in arte professor Apotema, di cui ho già recensito il primo libro su questo argomento.
Come aveva promesso ha continuato a scrivere e, dopo il volume in cui presenta i numeri iperreali, ora ne ha concluso uno nuovo, dedicato al calcolo delle differenze e al calcolo differenziale.
In 425 pagine vengono presentati, utilizzando l'approccio iperreale, argomenti molto noti, come le derivate, lo studio di funzione e i problemi di massimo e minimo, e anche argomenti poco noti (io, almeno, non li conoscevo), come il calcolo delle differenze, che sarebbe l'analogo discreto del calcolo differenziale. Esistono, ad esempio, formule sulle differenze discrete analoghe a quelle sulle derivate, esiste una versione discreta delle regole di de l'Hôpital, ed esiste persino una versione discreta del polinomio di Taylor, detto polinomio di Gregory-Newton. Il tutto è sempre presentato sotto forma di dialogo tra il professor Apotema e i suoi studenti.
Insomma, anche questo è un testo consigliatissimo.
Giorgio Goldoni, Il professor Apotema insegna: il calcolo delle differenze e il calcolo differenziale, ilmiolibro.it, 20€.
Qualche giorno fa alcuni di questi insegnanti si sono ritrovati a Venezia, al liceo Foscarini, per una giornata di studio e confronto sull'analisi infinitesimale; tra questi c'era anche Giorgio Goldoni, in arte professor Apotema, di cui ho già recensito il primo libro su questo argomento.
Come aveva promesso ha continuato a scrivere e, dopo il volume in cui presenta i numeri iperreali, ora ne ha concluso uno nuovo, dedicato al calcolo delle differenze e al calcolo differenziale.
In 425 pagine vengono presentati, utilizzando l'approccio iperreale, argomenti molto noti, come le derivate, lo studio di funzione e i problemi di massimo e minimo, e anche argomenti poco noti (io, almeno, non li conoscevo), come il calcolo delle differenze, che sarebbe l'analogo discreto del calcolo differenziale. Esistono, ad esempio, formule sulle differenze discrete analoghe a quelle sulle derivate, esiste una versione discreta delle regole di de l'Hôpital, ed esiste persino una versione discreta del polinomio di Taylor, detto polinomio di Gregory-Newton. Il tutto è sempre presentato sotto forma di dialogo tra il professor Apotema e i suoi studenti.
Insomma, anche questo è un testo consigliatissimo.
Giorgio Goldoni, Il professor Apotema insegna: il calcolo delle differenze e il calcolo differenziale, ilmiolibro.it, 20€.
venerdì 2 dicembre 2011
Le magie di Eulero
Prendiamo la funzione y = sin(x): bellina da disegnare, ma difficile da trattare. Va bene, pazienza, Taylor ha trovato una formula che permette di trasformare le funzioni difficili in polinomi. E allora possiamo scrivere che:
sin(x) = x - x3/3! + x5/5! - x7/7! + …
«Bé, non è proprio un polinomio questo, eh. Si deve andare avanti all'infinito, non ci si può fermare».
«Lo so, ma Eulero vedeva molto lontano, e ai tempi l'infinito veniva gestito in modo molto sportivo».
«Andiamo bene. E cosa ha combinato, Eulero?».
«Per prima cosa ha calcolato il polinomio…».
«…infinito…».
«…infinito, va bene, di sin(x)/x».
«Basta dividere per x, no?».
«Sì, e si ottiene questo:».
P(x) = sin(x)/x = 1 - x2/3! + x4/5! - x6/7! + …
«Questo era facile».
«Ora calcoliamo le radici di questo polinomio».
«Eh?».
«Vediamo in quali punti si annulla».
«Immagino che si annullerà quando è nullo il seno: in infiniti punti».
«Naturalmente. Quali sono?».
«Uhm, vediamo, π, 2π, 3π, …».
«Non dimenticare i valori negativi!».
«Ah, già, ci sono anche -π, -2π, eccetera. E anche lo zero».
«Eh, no, lo zero no».
«Perché?».
«Perché il dominio di sin(x)/x esclude lo zero, quello lo lasciamo fuori».
«Ah, giusto».
«Ora, un polinomio di qualsiasi grado può essere scomposto nel prodotto di tanti binomi del tipo (x-ri), dove gli ri sono le sue radici, moltiplicato per il coefficiente del termine di grado massimo».
«È vero, ma qui non c'è un grado massimo!».
«Infatti. Allora giriamo il problema, partiamo dal termine noto. Questo è, ehm, noto».
«Già, è uguale a 1».
«Allora esprimiamo questo polinomio come prodotto di tanti binomi del tipo (1-x/ri)».
«Uhm, fammi pensare… Certamente se svolgo i calcoli mi risulta un termine noto uguale a 1, ma non capisco bene il significato di quei binomi».
«Guarda bene: ognuno di loro si annulla se sostituisco al posto di x la radice ri».
«Ah, è vero. Quindi questo è un modo equivalente di scomporre, ho capito».
«Ottimo. Quindi il nostro P(x) è diventato questa espressione:».
P(x) = (1-x/r1)(1-x/r2)(1-x/r3)…
«Un prodotto infinito».
«Esatto. Ora ti ordino i vari valori di ri in modo da fare saltare fuori qualche prodotto notevole».
«Uh, quelli che si studiavano in prima superiore».
«Proprio loro. In particolare, userò la differenza tra due quadrati».
«Me la ricordo! Dice che (a+b)(a-b) è uguale a a2-b2».
«Perfetto. Guarda allora questa espressione di P(x) e prova a trasformarla:».
P(x) = (1-x/π)(1+x/π)(1-x/(2π))(1+x/(2π))…
«Ah, ho capito. A due a due le parentesi si moltiplicano, e ottengo questo:».
P(x) = (1-x2/π2)(1-x2/(2π)2)(1-x2/(3π)2)…
«Benissimo. Ora calcoliamo il prodotto».
«Eh? Stai scherzando? Come si fa? È infinito!».
«Sì, hai ragione. Calcoliamoci solo il termine di secondo grado».
«E come facciamo?».
«Osserva che in ogni parentesi compare una x di secondo grado…».
«E quindi i termini di secondo grado si hanno solo quando prendo una delle x e la moltiplico per tutti gli 1 che compaiono nelle altre parentesi!».
«Esatto, altrimenti ottieni gradi più alti».
«Allora forse ce la faccio a fare il calcolo, vediamo: dalla prima parentesi ottengo 1/π2…».
«Attenzione al segno!».
«Vero, sono tutti termini negativi. Allora, raccolgo un segno meno e non ci penso più: quindi, a parte il segno, ottengo questi numeri».
1/π2, 1/(2π2), 1/(3π2), …
«Bene. Questi numeri sono tutti sommati tra di loro, vero?».
«Certo, l'espressione finale che ottengo è questa:».
- 1/π2 - 1/(2π2) - 1/(3π2) - …
«Che ti scriverò in questo modo:».
«Eh? Cos'è quella lettera?».
«Si chiama funzione zeta di Riemann, ζ è la lettera greca zeta».
«Quella dell'ipotesi di Riemann?».
«Proprio lei».
«E allora? Cosa abbiamo ottenuto?».
«Abbiamo calcolato il valore di -ζ(2)/π2».
«Davvero? E come abbiamo fatto? Non vedo il risultato, ma solo una lunga (e discutibile) trasformazione».
«Eh, ma guarda l'inizio della trasformazione: non dimenticarti il punto di partenza».
«Ti riferisci a P(x)? Cioè a sin(x)/x?».
«Certamente. Qual è il coefficiente del termine di secondo grado, nella prima espressione di P(x)?».
«È -1/3!, cioè -1/6».
«Perfetto, allora -ζ(2)/π2 = -1/6, quindi ζ(2) = π2/6».
«Uhm, vabbé, carino, ma non ho capito a cosa ci ser…».
«COSA?».
«Ehm, no, mi chiedevo l'util…».
«TU NON STAI PENSANDO DA VERO MATEMATICO!».
«Uh, ecco, non volevo…».
«TI SEMBRANO DOMANDE DA FARE?».
«Mi dispiace…».
«SARÀ MEGLIO!».
sin(x) = x - x3/3! + x5/5! - x7/7! + …
«Bé, non è proprio un polinomio questo, eh. Si deve andare avanti all'infinito, non ci si può fermare».
«Lo so, ma Eulero vedeva molto lontano, e ai tempi l'infinito veniva gestito in modo molto sportivo».
«Andiamo bene. E cosa ha combinato, Eulero?».
«Per prima cosa ha calcolato il polinomio…».
«…infinito…».
«…infinito, va bene, di sin(x)/x».
«Basta dividere per x, no?».
«Sì, e si ottiene questo:».
P(x) = sin(x)/x = 1 - x2/3! + x4/5! - x6/7! + …
«Questo era facile».
«Ora calcoliamo le radici di questo polinomio».
«Eh?».
«Vediamo in quali punti si annulla».
«Immagino che si annullerà quando è nullo il seno: in infiniti punti».
«Naturalmente. Quali sono?».
«Uhm, vediamo, π, 2π, 3π, …».
«Non dimenticare i valori negativi!».
«Ah, già, ci sono anche -π, -2π, eccetera. E anche lo zero».
«Eh, no, lo zero no».
«Perché?».
«Perché il dominio di sin(x)/x esclude lo zero, quello lo lasciamo fuori».
«Ah, giusto».
«Ora, un polinomio di qualsiasi grado può essere scomposto nel prodotto di tanti binomi del tipo (x-ri), dove gli ri sono le sue radici, moltiplicato per il coefficiente del termine di grado massimo».
«È vero, ma qui non c'è un grado massimo!».
«Infatti. Allora giriamo il problema, partiamo dal termine noto. Questo è, ehm, noto».
«Già, è uguale a 1».
«Allora esprimiamo questo polinomio come prodotto di tanti binomi del tipo (1-x/ri)».
«Uhm, fammi pensare… Certamente se svolgo i calcoli mi risulta un termine noto uguale a 1, ma non capisco bene il significato di quei binomi».
«Guarda bene: ognuno di loro si annulla se sostituisco al posto di x la radice ri».
«Ah, è vero. Quindi questo è un modo equivalente di scomporre, ho capito».
«Ottimo. Quindi il nostro P(x) è diventato questa espressione:».
P(x) = (1-x/r1)(1-x/r2)(1-x/r3)…
«Un prodotto infinito».
«Esatto. Ora ti ordino i vari valori di ri in modo da fare saltare fuori qualche prodotto notevole».
«Uh, quelli che si studiavano in prima superiore».
«Proprio loro. In particolare, userò la differenza tra due quadrati».
«Me la ricordo! Dice che (a+b)(a-b) è uguale a a2-b2».
«Perfetto. Guarda allora questa espressione di P(x) e prova a trasformarla:».
P(x) = (1-x/π)(1+x/π)(1-x/(2π))(1+x/(2π))…
«Ah, ho capito. A due a due le parentesi si moltiplicano, e ottengo questo:».
P(x) = (1-x2/π2)(1-x2/(2π)2)(1-x2/(3π)2)…
«Benissimo. Ora calcoliamo il prodotto».
«Eh? Stai scherzando? Come si fa? È infinito!».
«Sì, hai ragione. Calcoliamoci solo il termine di secondo grado».
«E come facciamo?».
«Osserva che in ogni parentesi compare una x di secondo grado…».
«E quindi i termini di secondo grado si hanno solo quando prendo una delle x e la moltiplico per tutti gli 1 che compaiono nelle altre parentesi!».
«Esatto, altrimenti ottieni gradi più alti».
«Allora forse ce la faccio a fare il calcolo, vediamo: dalla prima parentesi ottengo 1/π2…».
«Attenzione al segno!».
«Vero, sono tutti termini negativi. Allora, raccolgo un segno meno e non ci penso più: quindi, a parte il segno, ottengo questi numeri».
1/π2, 1/(2π2), 1/(3π2), …
«Bene. Questi numeri sono tutti sommati tra di loro, vero?».
«Certo, l'espressione finale che ottengo è questa:».
- 1/π2 - 1/(2π2) - 1/(3π2) - …
«Che ti scriverò in questo modo:».
«Eh? Cos'è quella lettera?».
«Si chiama funzione zeta di Riemann, ζ è la lettera greca zeta».
«Quella dell'ipotesi di Riemann?».
«Proprio lei».
«E allora? Cosa abbiamo ottenuto?».
«Abbiamo calcolato il valore di -ζ(2)/π2».
«Davvero? E come abbiamo fatto? Non vedo il risultato, ma solo una lunga (e discutibile) trasformazione».
«Eh, ma guarda l'inizio della trasformazione: non dimenticarti il punto di partenza».
«Ti riferisci a P(x)? Cioè a sin(x)/x?».
«Certamente. Qual è il coefficiente del termine di secondo grado, nella prima espressione di P(x)?».
«È -1/3!, cioè -1/6».
«Perfetto, allora -ζ(2)/π2 = -1/6, quindi ζ(2) = π2/6».
«Uhm, vabbé, carino, ma non ho capito a cosa ci ser…».
«COSA?».
«Ehm, no, mi chiedevo l'util…».
«TU NON STAI PENSANDO DA VERO MATEMATICO!».
«Uh, ecco, non volevo…».
«TI SEMBRANO DOMANDE DA FARE?».
«Mi dispiace…».
«SARÀ MEGLIO!».
lunedì 14 novembre 2011
The Colossal Book of Short Puzzles and Problem
Quando scriveva la rubrica Mathematical Games su Scientific American, Martin Gardner non dedicava esclusivamente i suoi articoli ad approfondire un particolare argomento ma, ogni tanto, presentava invece brevi problemi, quesiti interessanti che potevano essere risolti con una qualche osservazione intelligente (la famosa esperienza aha!).
Nel 2004 Dana Richards ha raccolto tutti i quesiti brevi di Martin, li ha classificati rispetto al tipo di matematica necessaria per risolverli, e ha pubblicato il risultato sotto forma di un corposo volume:
The Colossal Book of Short Puzzles and Problems, scritto da Martin Gardner e sistemato da Dana Richards, Norton & Company, 22.04 euro.
Ecco il sommario:
Inutile dire che il giudizio è: una meraviglia.
Nel 2004 Dana Richards ha raccolto tutti i quesiti brevi di Martin, li ha classificati rispetto al tipo di matematica necessaria per risolverli, e ha pubblicato il risultato sotto forma di un corposo volume:
The Colossal Book of Short Puzzles and Problems, scritto da Martin Gardner e sistemato da Dana Richards, Norton & Company, 22.04 euro.
Ecco il sommario:
- Problemi combinatori e numerici (suddivisi in calcolo combinatorio, probabilità, numeri, algebra).
- Quesiti geometrici (suddivisi in geometria piana, geometria solida, forme e dissezioni, topologia).
- Giochi e quesiti algoritmici (suddivisi in procedure, pianificazione, giochi, scacchi).
- Altri enigmi (suddivisi in logica, criptoaritmetica, giochi di parole, oggetti fisici, fisica).
- Appendice (con 12 altri quesiti, il meglio tra quelli raccolti da Martin dopo la chiusura della sua rubrica, avvenuta nel 1986).
Inutile dire che il giudizio è: una meraviglia.
lunedì 7 novembre 2011
lunedì 24 ottobre 2011
Perché proprio la radice di n?
Per completare il post precedente sulla legge dei grandi numeri e il gioco di testa o croce, ecco perché la differenza tra numero di teste e numero di croci varia come la radice del numero di lanci.
Indichiamo con T(n) il numero di teste dopo n lanci, e con C(n) il numero di croci. La differenza D(n) è naturalmente uguale a T(n)-C(n).
Ogni volta che n aumenta di 1, il valore di D(n) o aumenta di 1 oppure diminuisce di 1, cioè:
D(n+1) = D(n)+1 oppure D(n+1) = D(n)-1.
Elevando al quadrato, si ottiene
D(n+1)2 = D(n)2 + 1 ± 2D(n).
E qui mi sono piantato, perché mi avevano spiegato una cosa di cui non ero convinto, sono rimasto lì a rimuginarci sopra per un po' di tempo, fino a che non ho capito che mi ponevo la domanda sbagliata. Come si dice, spesso la risposta a una domanda è la stessa domanda formulata meglio.
Ecco come stanno le cose: dalla formula scritta sopra vorrei passare al valor medio di D. Questo significa che devo immaginare di fare tante sequenze di lanci (virtualmente tutte le sequenze di lanci) e calcolare la media dei termini presenti nell'uguaglianza scritta qua sopra. Io pensavo invece di fare la media al variare di n, sbagliando.
Se quindi facciamo la media su tutte le possibili sequenze di testa o croce, otteniamo che il valor medio di
D(n+1)2 è uguale al valor medio di D(n)2 + 1, perché il valor medio di D(n) è zero. Infatti, per ogni sequenza di teste e croci esiste la sequenza gemella ottenuta scambiando di posto le teste con le croci, e quindi per ogni D(n) positivo esiste un D(n) negativo che annulla la somma. Ragionando invece su una singola sequenza di lanci, è chiaro che non possiamo dire molto su D(n), ogni sequenza fa quello che vuole e avrà una media di D(n) diversa.
Ma allora, se il valor medio di D(n+1)2 è uguale al valor medio di D(n)2 + 1, questo significa che il valore medio del quadrato di D(n) aumenta ogni volta di 1, e dopo n lanci vale quindi esattamente n.
E dunque la radice del valore medio di D(n)2, che si chiama scarto quadratico medio, è proprio la radice di n. Ecco fatto.
Concludo con un aneddoto finale: Enrico Fermi, dopo avere perso una partita a tennis a Los Alamos per 6-4 contro un matematico, gli disse che l'altro non poteva dire di avere vinto perché lo scarto era inferiore alla radice di n, con n = 6+4 = 10.
Indichiamo con T(n) il numero di teste dopo n lanci, e con C(n) il numero di croci. La differenza D(n) è naturalmente uguale a T(n)-C(n).
Ogni volta che n aumenta di 1, il valore di D(n) o aumenta di 1 oppure diminuisce di 1, cioè:
D(n+1) = D(n)+1 oppure D(n+1) = D(n)-1.
Elevando al quadrato, si ottiene
D(n+1)2 = D(n)2 + 1 ± 2D(n).
E qui mi sono piantato, perché mi avevano spiegato una cosa di cui non ero convinto, sono rimasto lì a rimuginarci sopra per un po' di tempo, fino a che non ho capito che mi ponevo la domanda sbagliata. Come si dice, spesso la risposta a una domanda è la stessa domanda formulata meglio.
Ecco come stanno le cose: dalla formula scritta sopra vorrei passare al valor medio di D. Questo significa che devo immaginare di fare tante sequenze di lanci (virtualmente tutte le sequenze di lanci) e calcolare la media dei termini presenti nell'uguaglianza scritta qua sopra. Io pensavo invece di fare la media al variare di n, sbagliando.
Se quindi facciamo la media su tutte le possibili sequenze di testa o croce, otteniamo che il valor medio di
D(n+1)2 è uguale al valor medio di D(n)2 + 1, perché il valor medio di D(n) è zero. Infatti, per ogni sequenza di teste e croci esiste la sequenza gemella ottenuta scambiando di posto le teste con le croci, e quindi per ogni D(n) positivo esiste un D(n) negativo che annulla la somma. Ragionando invece su una singola sequenza di lanci, è chiaro che non possiamo dire molto su D(n), ogni sequenza fa quello che vuole e avrà una media di D(n) diversa.
Ma allora, se il valor medio di D(n+1)2 è uguale al valor medio di D(n)2 + 1, questo significa che il valore medio del quadrato di D(n) aumenta ogni volta di 1, e dopo n lanci vale quindi esattamente n.
E dunque la radice del valore medio di D(n)2, che si chiama scarto quadratico medio, è proprio la radice di n. Ecco fatto.
Concludo con un aneddoto finale: Enrico Fermi, dopo avere perso una partita a tennis a Los Alamos per 6-4 contro un matematico, gli disse che l'altro non poteva dire di avere vinto perché lo scarto era inferiore alla radice di n, con n = 6+4 = 10.
venerdì 21 ottobre 2011
Sulla legge dei grandi numeri e problemi affini
Volevo spiegare agli studenti il fatto che due infiniti dello stesso ordine possono avere rapporto finito ma non differenza finita, e volevo farlo in modo che il concetto rimanesse ben impresso nella memoria.
Allora ho fatto l'esempio del gioco del testa-o-croce: se lancio una moneta, la probabilità che esca testa è uguale a 1/2, ed è uguale alla probabilità che esca croce. Se io eseguo il lancio molte volte, mi aspetto che il rapporto tra numero di teste e numero di croci si avvicini sempre di più a 1 (se la moneta non è truccata, naturalmente). Questo è, in sostanza, quello che dice la legge dei grandi numeri (la quale ha una formulazione più sottile: la convergenza a 1 del rapporto è una convergenza in probabilità, cioè il rapporto converge al valore teorico con probabilità 1 (e probabilità 1 non significa che avverrà certamente, ma che avverrà quasi certamente (sì, i Veri Matematici hanno dato un significato rigoroso anche al quasi, roba da matti))).
Ora vediamo l'inghippo: analizziamo una serie di lanci e scopriamo che testa è uscita per 42000 volte. Cosa deduciamo? La prima risposta è questa: anche il numero di croci sarà molto vicino a 42000.
Bene, questo è sbagliato. Si può dimostrare che la differenza tra teste e croci non rimane costante, ma varia come la radice quadrata del numero di lanci. Se ho fatto quindi circa 100000 lanci, posso aspettarmi una differenza anche di circa 300. D'accordo, 300 è piccolo rispetto a 100000, ma non importa: il fatto è che questo valore cresce sempre, e tende ad infinito.
Insomma, se noi vediamo che ci sono 300 teste in più e deduciamo che le croci sono ritardatarie, e che certamente prima o poi ne usciranno molte, sbagliamo clamorosamente.
Ora si può anche fare l'esempio algebrico: le due successioni N+√N e N hanno rapporto che tende a 1 e differenza che tende a infinito.
Ho poi portato gli studenti in laboratorio, e ho fatto scrivere agli increduli un programmino che simulasse il lancio di una moneta, in modo da verificare la teoria. Il fatto è che alcuni sono invece riusciti a falsificarla.
Confortato dalla certezza che i teoremi matematici non sono falsificabili, sono andato a cercare l'errore, e dopo un po' di ricerche ho capito cosa era successo.
Per simulare il lancio di una moneta, alcuni avevano utilizzato la seguente istruzione C:
che comporta le seguenti operazioni: crea un numero casuale con la funzione rand(), numero che è un intero compreso tra 0 e un valore massimo memorizzato all'interno della costante RAND_MAX, e guarda se è pari o dispari. Se è pari è uscita testa, se è dispari invece croce (o viceversa, non importa).
Bisogna ricordare che le funzioni che generano numeri casuali utilizzate dai vari linguaggi di programmazione non generano numeri davvero casuali: non c'è un omino, dentro al programma, che lancia un dado ogni volta che c'è bisogno. Ci sono invece delle funzioni matematiche che simulano la casualità, utilizzando tecniche diverse. Una delle più diffuse è quella che fa uso di un sistema che si chiama generatore lineare congruenziale, molto semplice da implementare, ma anche un po' scarsino. Sotto alcune condizioni, i bit meno significativi dei numeri pseudo-casuali generati con questo sistema hanno un periodo molto breve, e controllare se un numero è pari oppure dispari significa proprio utilizzare il bit meno significativo dell'intera sequenza. E quindi l'esperimento fallisce, perché le teste e le croci si presentano con preoccupante periodicità.
Come si fa allora a generare numeri casuali buoni?
In questo caso, l'istruzione che ho riportato qua sopra va sostituita da quest'altra:
che significa
Così funziona bene.
Il compilatore usato a scuola è il Dev C++, che evidentemente usa, nella sua funzione rand(), questo sistema poco affidabile. Ho controllato quello che succede nel gcc, e ho trovato che la libreria C presente sul mio sistema non presenta questo problema. Il manuale, però, dice che non si può essere sicuri del fatto che rand() funzioni bene su ogni implementazione di questa funzione.
Per essere sicuri, invece, del fatto che anche i bit meno significativi siano sufficientemente casuali, occorre usare un'altra funzione, che si chiama random().
Ecco allora un programmino che lancia una moneta 50000 volte e salva su file i risultati:
Il programma scrive su un file quattro colonne: nella prima c'è il rapporto teste/croci, nella seconda la differenza teste-croci, nelle ultime due i valori di più o meno la radice del numero dei lanci. Il tutto serve per produrre queso grafico:
La curva rossa è il rapporto teste/croci: si stabilizza rapidamente verso il valore 1 (tanto che sembra una retta orizzontale, ma non lo è). La curva blu, invece, è la differenza tra teste e croci: come si vede non si stabilizza per niente, anzi, oscilla molto e il suo andamento è compreso all'interno della parabola viola (non necessariamente all'interno: la variabilità della curva blu è dello stesso ordine di quella della parabola, cioè di più o meno radice del numero di lanci).
Allora ho fatto l'esempio del gioco del testa-o-croce: se lancio una moneta, la probabilità che esca testa è uguale a 1/2, ed è uguale alla probabilità che esca croce. Se io eseguo il lancio molte volte, mi aspetto che il rapporto tra numero di teste e numero di croci si avvicini sempre di più a 1 (se la moneta non è truccata, naturalmente). Questo è, in sostanza, quello che dice la legge dei grandi numeri (la quale ha una formulazione più sottile: la convergenza a 1 del rapporto è una convergenza in probabilità, cioè il rapporto converge al valore teorico con probabilità 1 (e probabilità 1 non significa che avverrà certamente, ma che avverrà quasi certamente (sì, i Veri Matematici hanno dato un significato rigoroso anche al quasi, roba da matti))).
Ora vediamo l'inghippo: analizziamo una serie di lanci e scopriamo che testa è uscita per 42000 volte. Cosa deduciamo? La prima risposta è questa: anche il numero di croci sarà molto vicino a 42000.
Bene, questo è sbagliato. Si può dimostrare che la differenza tra teste e croci non rimane costante, ma varia come la radice quadrata del numero di lanci. Se ho fatto quindi circa 100000 lanci, posso aspettarmi una differenza anche di circa 300. D'accordo, 300 è piccolo rispetto a 100000, ma non importa: il fatto è che questo valore cresce sempre, e tende ad infinito.
Insomma, se noi vediamo che ci sono 300 teste in più e deduciamo che le croci sono ritardatarie, e che certamente prima o poi ne usciranno molte, sbagliamo clamorosamente.
Ora si può anche fare l'esempio algebrico: le due successioni N+√N e N hanno rapporto che tende a 1 e differenza che tende a infinito.
Ho poi portato gli studenti in laboratorio, e ho fatto scrivere agli increduli un programmino che simulasse il lancio di una moneta, in modo da verificare la teoria. Il fatto è che alcuni sono invece riusciti a falsificarla.
Confortato dalla certezza che i teoremi matematici non sono falsificabili, sono andato a cercare l'errore, e dopo un po' di ricerche ho capito cosa era successo.
Per simulare il lancio di una moneta, alcuni avevano utilizzato la seguente istruzione C:
if (rand() % 2) == 1
che comporta le seguenti operazioni: crea un numero casuale con la funzione rand(), numero che è un intero compreso tra 0 e un valore massimo memorizzato all'interno della costante RAND_MAX, e guarda se è pari o dispari. Se è pari è uscita testa, se è dispari invece croce (o viceversa, non importa).
Bisogna ricordare che le funzioni che generano numeri casuali utilizzate dai vari linguaggi di programmazione non generano numeri davvero casuali: non c'è un omino, dentro al programma, che lancia un dado ogni volta che c'è bisogno. Ci sono invece delle funzioni matematiche che simulano la casualità, utilizzando tecniche diverse. Una delle più diffuse è quella che fa uso di un sistema che si chiama generatore lineare congruenziale, molto semplice da implementare, ma anche un po' scarsino. Sotto alcune condizioni, i bit meno significativi dei numeri pseudo-casuali generati con questo sistema hanno un periodo molto breve, e controllare se un numero è pari oppure dispari significa proprio utilizzare il bit meno significativo dell'intera sequenza. E quindi l'esperimento fallisce, perché le teste e le croci si presentano con preoccupante periodicità.
Come si fa allora a generare numeri casuali buoni?
In questo caso, l'istruzione che ho riportato qua sopra va sostituita da quest'altra:
if ((float) rand()/RAND_MAX) < 0.5
che significa
- genera un numero casuale intero compreso tra 0 e RAND_MAX,
- trasformalo in un numero float (con la virgola, insomma),
- dividilo per RAND_MAX, ottenendo così un numero compreso tra 0 e 1,
- se è minore di 0.5 è uscita testa, altrimenti croce.
Così funziona bene.
Il compilatore usato a scuola è il Dev C++, che evidentemente usa, nella sua funzione rand(), questo sistema poco affidabile. Ho controllato quello che succede nel gcc, e ho trovato che la libreria C presente sul mio sistema non presenta questo problema. Il manuale, però, dice che non si può essere sicuri del fatto che rand() funzioni bene su ogni implementazione di questa funzione.
Per essere sicuri, invece, del fatto che anche i bit meno significativi siano sufficientemente casuali, occorre usare un'altra funzione, che si chiama random().
Ecco allora un programmino che lancia una moneta 50000 volte e salva su file i risultati:
#define NUM 50000
#include<stdio.h>
#include<stdlib.h>
#include<time.h>
#include<math.h>
/* viene usata la funzione random() al posto di rand() perche' usa
un generatore di numeri casuali migliore. In vecche implementazioni
di rand(), ad esempio, i bit meno significativi hanno un periodo
molto breve, per cui non si puo' usare rand()%2 per estrarre un
numero compreso tra 0 e 1
*/
int main(void)
{
int i,t=0,c=0;
FILE *f=fopen("grandinumeri.csv","wt");
srandom((unsigned)time(NULL));
for (i=0;i<NUM;i++) {
if ((float) random()/RAND_MAX < 0.5) {
t++;
}
else {
c++;
}
if (c!=0) { // salto i primi calcoli fino a che non ho almeno una c
fprintf(f,"%f, %d, %f, %f\n",(float)t/c,t-c,sqrt(i),-sqrt(i));
}
}
fclose(f);
}
Il programma scrive su un file quattro colonne: nella prima c'è il rapporto teste/croci, nella seconda la differenza teste-croci, nelle ultime due i valori di più o meno la radice del numero dei lanci. Il tutto serve per produrre queso grafico:
La curva rossa è il rapporto teste/croci: si stabilizza rapidamente verso il valore 1 (tanto che sembra una retta orizzontale, ma non lo è). La curva blu, invece, è la differenza tra teste e croci: come si vede non si stabilizza per niente, anzi, oscilla molto e il suo andamento è compreso all'interno della parabola viola (non necessariamente all'interno: la variabilità della curva blu è dello stesso ordine di quella della parabola, cioè di più o meno radice del numero di lanci).
giovedì 20 ottobre 2011
giovedì 13 ottobre 2011
In onore di Ritchie
#define _ -F<00||--F-OO--;
int F=00,OO=00;main(){F_OO();printf("%1.3f\n",4.*-F/OO/OO);}F_OO()
{
_-_-_-_
_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_-_-_-_-_
_-_-_-_-_-_-_-_
_-_-_-_
}
Un programma in K&R C che calcola il valore di pi greco analizzando la propria area.
(
Se lo si vuole compilare su sistemi moderni, occorre questo comando:
gcc -traditional-cpp -o r r.c
)
Dimostrazione senza parole: sin(α+β)
Ne ho trovata un'altra:
L'area del parallelogramma di sinistra (quello bianco) è uguale a sin(α+β), ed è anche uguale alla somma delle aree dei due rettangoli bianchi di destra, cioè sin(α)cos(β)+cos(α)sin(β).
sabato 8 ottobre 2011
Martin Gardner — The Colossal Book of Mathematics
Se siete interessati agli articoli di Martin Gardner e non avete voglia di recuperare in giro tutti i suoi libri, potete risparmiare un po' di fatica con questo:
Martin Gardner, The Colossal Book of Mathematics, Norton, 25.74 euro.
Si tratta della raccolta dei pezzi più popolari scritti da Martin per la rubrica Mathematical Games di Scientific American: 736 pagine di arte della divulgazione matematica.
Gli articoli sono divisi per argomento: troviamo una prima parte sulla teoria dei numeri, seguita dall'algebra, la geometria, la probabilità, la topologia, la teoria dei giochi, l'infinito, il calcolo combinatorio, la fisica, la logica, la filosofia e altro ancora. Ci sono i flexagoni, il gioco Life, i polimini… insomma, c'è di tutto.
Per motivi che diventeranno chiari tra qualche giorno segnalo in particolare il capitolo 5, intitolato Rep-Tiles: un gioco di parole intraducibile, perché i reptiles sono i rettili, ma anche le tessere (tiles) che vengono replicate.
In pratica i rep-tiles sono poligoni formati da pezzi uguali tra loro e, possibilmente, aventi la stessa forma del poligono originale. Tipo questo:
Se siete appassionati di matematica ricreativa, questa roba è da leggere.
Martin Gardner, The Colossal Book of Mathematics, Norton, 25.74 euro.
Si tratta della raccolta dei pezzi più popolari scritti da Martin per la rubrica Mathematical Games di Scientific American: 736 pagine di arte della divulgazione matematica.
Gli articoli sono divisi per argomento: troviamo una prima parte sulla teoria dei numeri, seguita dall'algebra, la geometria, la probabilità, la topologia, la teoria dei giochi, l'infinito, il calcolo combinatorio, la fisica, la logica, la filosofia e altro ancora. Ci sono i flexagoni, il gioco Life, i polimini… insomma, c'è di tutto.
Per motivi che diventeranno chiari tra qualche giorno segnalo in particolare il capitolo 5, intitolato Rep-Tiles: un gioco di parole intraducibile, perché i reptiles sono i rettili, ma anche le tessere (tiles) che vengono replicate.
In pratica i rep-tiles sono poligoni formati da pezzi uguali tra loro e, possibilmente, aventi la stessa forma del poligono originale. Tipo questo:
Se siete appassionati di matematica ricreativa, questa roba è da leggere.
mercoledì 5 ottobre 2011
Questo è il titolo di questa storia, che si trova anche parecchie volte nella storia stessa
Questa è la prima frase di questa storia. Questa è la seconda frase. Questo è il titolo di questa storia, che si trova anche parecchie volte nella storia stessa. Questa frase si interroga sul valore intrinseco delle prime due frasi. Questa frase vi informa, nel caso non ve ne foste già accorti, che questa è una storia autoreferenziale, cioè una storia formata da frasi che si riferiscono alla loro propria struttura e funzione. Questa è una frase che serve per finire il primo capoverso.
Questa è la prima frase di un nuovo capoverso di una storia autoreferenziale. Questa frase vi fa conoscere il protagonista della storia, un ragazzo di nome Billy. Questa frase vi dice che Billy è biondo, con gli occhi azzurri, americano, ha 12 anni e strangola sua madre. Questa frase fa un commento sulla goffa natura della forma narrativa autoreferenziale mentre riconosce lo strano e divertente distacco che garantisce allo scrittore. Come per illustrare quanto detto nell'ultima frase, questa frase ci ricorda, senza ombra di facezia, che i bambini sono un prezioso dono divino e che il mondo è un posto migliore quando è benedetto dalle gioie e delizie che essi vi portano.
Questa frase descrive gli occhi della madre di Billy che schizzano fuori dalle orbite e la sua lingua che penzola e fa riferimento agli spiacevoli gorgoglii che sta emettendo. Questa frase fa l'osservazione che questi sono tempi incerti e difficili e che i rapporti, anche quelli apparentemente permanenti e profondamente radicati, hanno la tendenza a rompersi.
Introduce in questo capoverso l'espediente dei frammenti di frase. Un frammento di frase. Un altro. Buon espediente. Sarà più usato in seguito.
Questa è in realtà l'ultima frase della storia, ma è stata messa qui per sbaglio. Questo è il titolo di questa storia, che si trova anche parecchie volte nella storia stessa. Svegliatosi una mattina uscendo da sgradevoli sogni, Gregor Samsa si trovò nel suo letto trasformato in un gigantesco insetto. Questa frase vi informa che la frase precedente è di un'altra storia (una molto migliore, va detto) e non c'entra niente in questo passo della narrazione. A dispetto delle affermazioni della frase precedente, questa frase si sente obbligata a informarvi che la storia che state leggendo è in realtà "La metamorfosi", di Franz Kafka, e che la frase a cui ci si riferiva nella frase precedente è l'unica frase che appartiene davvero a questa storia. Questa frase annulla la frase precedente informando il lettore (povero, confuso infelice) che questo brano letterario è in realtà la Dichiarazione di indipendenza, ma che l'autore, in un gesto di estrema negligenza (se non di malizioso sabotaggio), non ha finora incluso nemmeno una sola frase di quel commovente documento, anche se ha accondisceso a usare un piccolo frammento di frase, vale a dire "quando nel corso degli umani eventi", chiuso tra virgolette vicino alla fine della frase. Mostrando una chiara consapevolezza della noia e della sincera ostilità del lettore medio verso gli inutili giochi concettuali a cui si indulgeva nelle frasi precedenti, questa frase ci riporta infine allo scenario della storia ponendo la domanda: "Perché Billy strangola sua madre?" Questa frase cerca di fare un po’ di luce sulla domanda posta dalla frase precedente, ma non ci riesce. Questa frase, invece, ci riesce suggerendo una possibile relazione incestuosa tra Billy e sua madre e alludendo alle concomitanti complicazioni freudiane che ogni lettore astuto vedrà immediatamente. Incesto. L'innominabile tabù. La proibizione universale. Incesto. E si notano i frammenti di frase? Buon espediente letterario. Sarà più usato in seguito.
Questa è la prima frase di un nuovo capoverso. Questa è l'ultima frase di un nuovo capoverso.
Questa frase può servire sia da inizio di un capoverso sia da fine, a seconda della sua posizione. Questo è il titolo di questa storia, che si trova anche parecchie volte nella storia stessa. Questa frase solleva una seria obiezione verso l'intera classe di frasi autoreferenziali che si limitano a commentare la propria funzione o la propria posizione all'interno della storia (ad esempio le ultime quattro frasi), per il fatto che esse sono monotonamente prevedibili, indimenticabilmente autoindulgenti e servono semplicemente a distrarre il lettore dal vero argomento di questa storia, che a questo punto sembra avere a che fare con strangolamento e incesto e chissà quali altre delizie. Lo scopo di questa frase è rilevare che la frase precedente, anche se non appartiene essa stessa alla classe di frasi autoreferenziali contro cui solleva obiezioni, nondimeno serve anch'essa semplicemente a distrarre il lettore dal vero argomento di questa storia, che in realtà ha a che fare con l'inesplicabile trasformazione di Gregor Samsa in un insetto gigantesco (a dispetto delle rumorose affermazioni contrarie di altre benintenzionate, ma male informate frasi). Questa frase può servire sia da inizio di un capoverso sia da fine, a seconda della sua posizione.
Questo è il titolo di questa storia, che si trova anche parecchie volte nella storia stessa. Questo è quasi il titolo di questa storia, che si trova solo una volta nella storia stessa. Questa frase afferma a malincuore che fino a questo punto il modo narrativo autoreferenziale ha avuto un effetto paralizzante sul progresso della storia stessa, cioè queste frasi sono state talmente impegnate ad analizzare se stesse e il loro ruolo nella storia che hanno finito per non compiere la loro funzione di comunicatori di eventi e idee che uno spera si fondano in una trama, in uno sviluppo dei personaggi, ecc., in breve, la vera raison d'étre di ogni rispettabile frase all'interno di un brano di irresistibile prosa. Questa frase rileva inoltre l'ovvia analogia tra la condizione di queste agonizzanti frasi autocoscienti e le analoghe afflizioni degli esseri umani, e sottolinea gli analoghi effetti paralizzanti che scaturiscono da un'eccessiva e torturata autoanalisi.
Lo scopo di questa frase (che può anche servire da capoverso) è di riflettere che se la Dichiarazione di indipendenza fosse stata formulata e strutturata allo stesso modo lezioso e incoerente di questa storia, non si potrebbe dire in che tipo di corrotta società libertina vivremmo ora o in quali abissi di decadenza potrebbero essere precipitati gli abitanti di questo paese, fino al punto che scrittori squilibrati e degradati costruiscano frasi irritantemente ingombranti e inutilmente prolisse che a volte possiedono la discutibile se non del tutto indesiderabile proprietà di riferirsi a se stesse ed esse a volte arrivano a divenire frasi sconclusionate o mostrano altri segni di inescusabile sciatteria grammaticale quali non necessarie ridondanze superflue che quasi certamente avrebbero insidiosi effetti sullo stile di vita e sulla morale della nostra impressionabile gioventù, portandola a commettere incesto o addirittura assassinio e forse è per questo che Billy sta strangolando sua madre, a causa di frasi proprio come questa, che non hanno obiettivi discernibili o scopi perspicui e terminano in un punto qualsiasi, anche in mez
Bizzarro. Un frammento di frase. Un altro frammento. Dodici anni. Questa è una frase che. Frammentata. E strangolando sua madre. Scusate, scusate. Bizzarro. Questo. Più frammenti. Questo è. Frammenti. Il titolo di questa storia, che. Biondo. Scusate, scusate. Frammento dopo frammento. Più difficile. Questa è una frase che. Frammenti. Diavolo buon espediente.
Lo scopo di questa frase è triplice: (1) scusarsi per la sfortunata e inesplicabile scorrettezza nel capoverso precedente; (2) assicurarti, lettore, che non accadrà più; e (3) ripetere l'affermazione che questi sono tempi incerti e difficili e che aspetti del linguaggio, anche quelli apparentemente stabili e profondamente radicati come la sintassi e il significato, si spezzano. Questa frase non aggiunge nulla di sostanziale a ciò che è stato espresso nella frase precedente, ma serve semplicemente da frase conclusiva per questo capoverso, che altrimenti potrebbe non averne una.
Questa frase, in un improvviso e coraggioso soprassalto di altruismo, cerca di abbandonare il modo autoreferenziale, ma fallisce. Questa frase cerca di nuovo, ma il tentativo è condannato in partenza.
Questa frase, in un ultimo e disperato tentativo di infondere un minimo di narrazione in questa prosa paralizzata, allude rapidamente ai frenetici tentativi di Billy di nascondersi, seguita da un lirico, toccante e bel passaggio in cui Billy si riconcilia con suo padre (risolvendo così i subliminali conflitti freudiani che risultano ovvi a qualsiasi astuto lettore) e da un’eccitante scena finale di caccia da parte della polizia durante la quale Billy è accidentalmente colpito e ucciso da una recluta della polizia in preda al panico che per coincidenza si chiama anch'essa Billy. Questa frase, anche se fondamentalmente in completa simpatia con i lodevoli sforzi dell'ultima frase densa d'azione, ricorda al lettore che queste allusioni a una storia che in realtà non esiste ancora non sono in alcun modo sostituti della cosa reale e pertanto non possono tirar fuori l'autore (quello stupido indolente) dalla proverbiale trappola.
Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso.
Lo scopo. Di questo capoverso. È di scusarsi. Per l'uso gratuito. Di. Frammenti di frase. Scusate.
Lo scopo di questa frase è scusarsi per gli inutili e sciocchi giochetti da adolescenti a cui si indulgeva nei due precedenti capoverso, ed esprimere da parte di noi, le frasi più mature, il rincrescimento per il fatto che, nel complesso, il tono di questa storia è tale da non riuscire a comunicare un semplice, per quanto un po' torbido, scenario.
Questa frase desidera scusarsi per le inutili scuse che si trovano in questa storia (questa inclusa), che, anche se manifestamente qui poste a beneficio dei lettori più irritati, non fanno che ritardare in modo esasperantemente ripetitivo la prosecuzione dell'ormai quasi dimenticata linea narrativa.
Questa frase mette l'accento sul terribile significato dell'autoriferimento applicato alle frasi, una pratica che potrebbe dimostrarsi un vero vaso di Pandora di potenziale rovina, in quanto se una frase può riferirsi o alludere a se stessa, perché non un'umile proposizione subordinata, magari proprio questa? O questo frammento di frase? O tre parole? Due parole? Una?
Forse è giusto che questa frase ci ricordi gentilmente e senza ombra di condiscendenza che questi sono davvero tempi difficili e incerti e che in genere le persone non sono buone l'una con l'altra, e che forse noi, esseri umani senzienti o frasi senzienti che siamo, dovremmo sforzarci di più. Voglio dire che c'è qualcosa come il libero arbitrio, ci deve essere, e questa frase ne è la prova! Nè questa frase nè tu, lettore, siete completamente senza speranza davanti alle impietose forze che operano nell'universo. Dovremmo stare ben piantati per terra, affrontare i fatti, prendere Madre Natura per il collo e sforzarci di più. Per la gola. Di più. Di più, di più.
Scusate.
Questo è il titolo di questa storia, che si trova anche parecchie volte nella storia stessa.
Questa è l'ultima frase della storia. Questa è l'ultima frase della storia. Questa è l'ultima frase della storia. Questa è. Scusate.
(David Moser, riportato da Hofstadter sulla rubrica Temi Metamagici di un Le Scienze di tanti anni fa)
Questa è la prima frase di un nuovo capoverso di una storia autoreferenziale. Questa frase vi fa conoscere il protagonista della storia, un ragazzo di nome Billy. Questa frase vi dice che Billy è biondo, con gli occhi azzurri, americano, ha 12 anni e strangola sua madre. Questa frase fa un commento sulla goffa natura della forma narrativa autoreferenziale mentre riconosce lo strano e divertente distacco che garantisce allo scrittore. Come per illustrare quanto detto nell'ultima frase, questa frase ci ricorda, senza ombra di facezia, che i bambini sono un prezioso dono divino e che il mondo è un posto migliore quando è benedetto dalle gioie e delizie che essi vi portano.
Questa frase descrive gli occhi della madre di Billy che schizzano fuori dalle orbite e la sua lingua che penzola e fa riferimento agli spiacevoli gorgoglii che sta emettendo. Questa frase fa l'osservazione che questi sono tempi incerti e difficili e che i rapporti, anche quelli apparentemente permanenti e profondamente radicati, hanno la tendenza a rompersi.
Introduce in questo capoverso l'espediente dei frammenti di frase. Un frammento di frase. Un altro. Buon espediente. Sarà più usato in seguito.
Questa è in realtà l'ultima frase della storia, ma è stata messa qui per sbaglio. Questo è il titolo di questa storia, che si trova anche parecchie volte nella storia stessa. Svegliatosi una mattina uscendo da sgradevoli sogni, Gregor Samsa si trovò nel suo letto trasformato in un gigantesco insetto. Questa frase vi informa che la frase precedente è di un'altra storia (una molto migliore, va detto) e non c'entra niente in questo passo della narrazione. A dispetto delle affermazioni della frase precedente, questa frase si sente obbligata a informarvi che la storia che state leggendo è in realtà "La metamorfosi", di Franz Kafka, e che la frase a cui ci si riferiva nella frase precedente è l'unica frase che appartiene davvero a questa storia. Questa frase annulla la frase precedente informando il lettore (povero, confuso infelice) che questo brano letterario è in realtà la Dichiarazione di indipendenza, ma che l'autore, in un gesto di estrema negligenza (se non di malizioso sabotaggio), non ha finora incluso nemmeno una sola frase di quel commovente documento, anche se ha accondisceso a usare un piccolo frammento di frase, vale a dire "quando nel corso degli umani eventi", chiuso tra virgolette vicino alla fine della frase. Mostrando una chiara consapevolezza della noia e della sincera ostilità del lettore medio verso gli inutili giochi concettuali a cui si indulgeva nelle frasi precedenti, questa frase ci riporta infine allo scenario della storia ponendo la domanda: "Perché Billy strangola sua madre?" Questa frase cerca di fare un po’ di luce sulla domanda posta dalla frase precedente, ma non ci riesce. Questa frase, invece, ci riesce suggerendo una possibile relazione incestuosa tra Billy e sua madre e alludendo alle concomitanti complicazioni freudiane che ogni lettore astuto vedrà immediatamente. Incesto. L'innominabile tabù. La proibizione universale. Incesto. E si notano i frammenti di frase? Buon espediente letterario. Sarà più usato in seguito.
Questa è la prima frase di un nuovo capoverso. Questa è l'ultima frase di un nuovo capoverso.
Questa frase può servire sia da inizio di un capoverso sia da fine, a seconda della sua posizione. Questo è il titolo di questa storia, che si trova anche parecchie volte nella storia stessa. Questa frase solleva una seria obiezione verso l'intera classe di frasi autoreferenziali che si limitano a commentare la propria funzione o la propria posizione all'interno della storia (ad esempio le ultime quattro frasi), per il fatto che esse sono monotonamente prevedibili, indimenticabilmente autoindulgenti e servono semplicemente a distrarre il lettore dal vero argomento di questa storia, che a questo punto sembra avere a che fare con strangolamento e incesto e chissà quali altre delizie. Lo scopo di questa frase è rilevare che la frase precedente, anche se non appartiene essa stessa alla classe di frasi autoreferenziali contro cui solleva obiezioni, nondimeno serve anch'essa semplicemente a distrarre il lettore dal vero argomento di questa storia, che in realtà ha a che fare con l'inesplicabile trasformazione di Gregor Samsa in un insetto gigantesco (a dispetto delle rumorose affermazioni contrarie di altre benintenzionate, ma male informate frasi). Questa frase può servire sia da inizio di un capoverso sia da fine, a seconda della sua posizione.
Questo è il titolo di questa storia, che si trova anche parecchie volte nella storia stessa. Questo è quasi il titolo di questa storia, che si trova solo una volta nella storia stessa. Questa frase afferma a malincuore che fino a questo punto il modo narrativo autoreferenziale ha avuto un effetto paralizzante sul progresso della storia stessa, cioè queste frasi sono state talmente impegnate ad analizzare se stesse e il loro ruolo nella storia che hanno finito per non compiere la loro funzione di comunicatori di eventi e idee che uno spera si fondano in una trama, in uno sviluppo dei personaggi, ecc., in breve, la vera raison d'étre di ogni rispettabile frase all'interno di un brano di irresistibile prosa. Questa frase rileva inoltre l'ovvia analogia tra la condizione di queste agonizzanti frasi autocoscienti e le analoghe afflizioni degli esseri umani, e sottolinea gli analoghi effetti paralizzanti che scaturiscono da un'eccessiva e torturata autoanalisi.
Lo scopo di questa frase (che può anche servire da capoverso) è di riflettere che se la Dichiarazione di indipendenza fosse stata formulata e strutturata allo stesso modo lezioso e incoerente di questa storia, non si potrebbe dire in che tipo di corrotta società libertina vivremmo ora o in quali abissi di decadenza potrebbero essere precipitati gli abitanti di questo paese, fino al punto che scrittori squilibrati e degradati costruiscano frasi irritantemente ingombranti e inutilmente prolisse che a volte possiedono la discutibile se non del tutto indesiderabile proprietà di riferirsi a se stesse ed esse a volte arrivano a divenire frasi sconclusionate o mostrano altri segni di inescusabile sciatteria grammaticale quali non necessarie ridondanze superflue che quasi certamente avrebbero insidiosi effetti sullo stile di vita e sulla morale della nostra impressionabile gioventù, portandola a commettere incesto o addirittura assassinio e forse è per questo che Billy sta strangolando sua madre, a causa di frasi proprio come questa, che non hanno obiettivi discernibili o scopi perspicui e terminano in un punto qualsiasi, anche in mez
Bizzarro. Un frammento di frase. Un altro frammento. Dodici anni. Questa è una frase che. Frammentata. E strangolando sua madre. Scusate, scusate. Bizzarro. Questo. Più frammenti. Questo è. Frammenti. Il titolo di questa storia, che. Biondo. Scusate, scusate. Frammento dopo frammento. Più difficile. Questa è una frase che. Frammenti. Diavolo buon espediente.
Lo scopo di questa frase è triplice: (1) scusarsi per la sfortunata e inesplicabile scorrettezza nel capoverso precedente; (2) assicurarti, lettore, che non accadrà più; e (3) ripetere l'affermazione che questi sono tempi incerti e difficili e che aspetti del linguaggio, anche quelli apparentemente stabili e profondamente radicati come la sintassi e il significato, si spezzano. Questa frase non aggiunge nulla di sostanziale a ciò che è stato espresso nella frase precedente, ma serve semplicemente da frase conclusiva per questo capoverso, che altrimenti potrebbe non averne una.
Questa frase, in un improvviso e coraggioso soprassalto di altruismo, cerca di abbandonare il modo autoreferenziale, ma fallisce. Questa frase cerca di nuovo, ma il tentativo è condannato in partenza.
Questa frase, in un ultimo e disperato tentativo di infondere un minimo di narrazione in questa prosa paralizzata, allude rapidamente ai frenetici tentativi di Billy di nascondersi, seguita da un lirico, toccante e bel passaggio in cui Billy si riconcilia con suo padre (risolvendo così i subliminali conflitti freudiani che risultano ovvi a qualsiasi astuto lettore) e da un’eccitante scena finale di caccia da parte della polizia durante la quale Billy è accidentalmente colpito e ucciso da una recluta della polizia in preda al panico che per coincidenza si chiama anch'essa Billy. Questa frase, anche se fondamentalmente in completa simpatia con i lodevoli sforzi dell'ultima frase densa d'azione, ricorda al lettore che queste allusioni a una storia che in realtà non esiste ancora non sono in alcun modo sostituti della cosa reale e pertanto non possono tirar fuori l'autore (quello stupido indolente) dalla proverbiale trappola.
Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso. Capoverso.
Lo scopo. Di questo capoverso. È di scusarsi. Per l'uso gratuito. Di. Frammenti di frase. Scusate.
Lo scopo di questa frase è scusarsi per gli inutili e sciocchi giochetti da adolescenti a cui si indulgeva nei due precedenti capoverso, ed esprimere da parte di noi, le frasi più mature, il rincrescimento per il fatto che, nel complesso, il tono di questa storia è tale da non riuscire a comunicare un semplice, per quanto un po' torbido, scenario.
Questa frase desidera scusarsi per le inutili scuse che si trovano in questa storia (questa inclusa), che, anche se manifestamente qui poste a beneficio dei lettori più irritati, non fanno che ritardare in modo esasperantemente ripetitivo la prosecuzione dell'ormai quasi dimenticata linea narrativa.
Questa frase mette l'accento sul terribile significato dell'autoriferimento applicato alle frasi, una pratica che potrebbe dimostrarsi un vero vaso di Pandora di potenziale rovina, in quanto se una frase può riferirsi o alludere a se stessa, perché non un'umile proposizione subordinata, magari proprio questa? O questo frammento di frase? O tre parole? Due parole? Una?
Forse è giusto che questa frase ci ricordi gentilmente e senza ombra di condiscendenza che questi sono davvero tempi difficili e incerti e che in genere le persone non sono buone l'una con l'altra, e che forse noi, esseri umani senzienti o frasi senzienti che siamo, dovremmo sforzarci di più. Voglio dire che c'è qualcosa come il libero arbitrio, ci deve essere, e questa frase ne è la prova! Nè questa frase nè tu, lettore, siete completamente senza speranza davanti alle impietose forze che operano nell'universo. Dovremmo stare ben piantati per terra, affrontare i fatti, prendere Madre Natura per il collo e sforzarci di più. Per la gola. Di più. Di più, di più.
Scusate.
Questo è il titolo di questa storia, che si trova anche parecchie volte nella storia stessa.
Questa è l'ultima frase della storia. Questa è l'ultima frase della storia. Questa è l'ultima frase della storia. Questa è. Scusate.
(David Moser, riportato da Hofstadter sulla rubrica Temi Metamagici di un Le Scienze di tanti anni fa)
martedì 4 ottobre 2011
lunedì 3 ottobre 2011
Sostiene Bollani
Ieri sera, durante la terza puntata, ha eseguito 4'33" di John Cage. Non ce n'è più per nessuno.
domenica 25 settembre 2011
Una vittoria epocale per la ricerca scientifica di tutto il mondo
Ecco, secondo me questa è una vittoria epocale:
Essere in grado di misurare la deriva dei continenti. Questi grafici ci mostrano la variazione della famosa distanza Cern-Gran Sasso nel corso degli anni. Sull'asse orizzontale vediamo gli anni, sull'asse verticale i metri. Dalla seconda metà del 2008 all'inizio del 2010 è stato misurato uno spostamento di 10 centimetri dovuto alla deriva dei continenti e, purtroppo, a un evento improvviso avvenuto il 6 aprile 2009: il terremoto dell'Aquila.
venerdì 23 settembre 2011
I logaritmi come li fanno i computer — parte 8
Dopo aver calcolato seno e coseno (e quindi tangente), abbiamo visto come usare il ventaglio all'indietro per calcolare l'arcotangente. Ora che sappiamo calcolare seno e coseno iperbolici (e quindi la tangente iperbolica), siamo anche in grado di calcolare l'arcotangente iperbolica.
L'algoritmo è questo:
Z0 = 0,
S0 = C0T,
Zm+1 = Zm-DmBm,
Cm+1 = Cm+EmDmSm,
Sm+1 = Sm+EmDmCm.
D è uguale a +1 oppure a -1, in modo tale che DC e S abbiano segno opposto. In questo modo, detto T il valore di ingresso, l'algoritmo calcola l'arcotangente iperbolica di T, che viene memorizzato come S0/C0. Ecco un programmino:
Ed ecco il solito output:
Ora manca solo la formula finale:
E quindi, grazie all'arcotangente iperbolica, finalmente siamo in grado di calcolare il logaritmo.
Bene, ci sarebbero anche altre cose da dire: per esempio, un sottoprodotto di questo algoritmo è il calcolo della radice quadrata. Se poi modifichiamo leggermente l'algoritmo, sostituendo la riga che calcola i valori di C con un'altra riga che lascia C invariato durante tutto il calcolo, otteniamo come risultato un metodo per fare la divisione tra due numeri.
Tutte queste belle cose sono spiegate qui. Qui, poi, c'è un articolo del 1971, scritto da un signore della Hewlett-Packard, che spiega l'implementazione del CORDIC sulle calcolatrici HP. Infine, qui c'è un intero libro dedicato agli aspetti più tecnici di questa roba: un libro, dice la prefazione, per computazionalisti. Per quanto mi riguarda, posso ritenermi soddisfatto.
L'algoritmo è questo:
Z0 = 0,
S0 = C0T,
Zm+1 = Zm-DmBm,
Cm+1 = Cm+EmDmSm,
Sm+1 = Sm+EmDmCm.
D è uguale a +1 oppure a -1, in modo tale che DC e S abbiano segno opposto. In questo modo, detto T il valore di ingresso, l'algoritmo calcola l'arcotangente iperbolica di T, che viene memorizzato come S0/C0. Ecco un programmino:
from math import atanh,cosh,sinh angoh=[] indici=[1,2,3,4,4,5,6,7,7,8,9,10,11,11,12,13,14,14,15,16,16,17,18,18] for i in indici: angoh+=[atanh(1./2**i)] def arcotanh(x): z0=0 c0=1. s0=c0*x for i,b in enumerate(angoh): if c0*s0<0: d=1 else: d=-1 z1 = z0-d*b c1 = c0+d*s0/2**indici[i] s1 = s0+d*c0/2**indici[i] z0,c0,s0 = z1,c1,s1 return z0 v1=arcotanh(1./3) v2=atanh(1./3) print v1,v2,abs(v1-v2)
Ed ecco il solito output:
0.346576305126 0.34657359028 2.71484642883e-06
Ora manca solo la formula finale:
E quindi, grazie all'arcotangente iperbolica, finalmente siamo in grado di calcolare il logaritmo.
Bene, ci sarebbero anche altre cose da dire: per esempio, un sottoprodotto di questo algoritmo è il calcolo della radice quadrata. Se poi modifichiamo leggermente l'algoritmo, sostituendo la riga che calcola i valori di C con un'altra riga che lascia C invariato durante tutto il calcolo, otteniamo come risultato un metodo per fare la divisione tra due numeri.
Tutte queste belle cose sono spiegate qui. Qui, poi, c'è un articolo del 1971, scritto da un signore della Hewlett-Packard, che spiega l'implementazione del CORDIC sulle calcolatrici HP. Infine, qui c'è un intero libro dedicato agli aspetti più tecnici di questa roba: un libro, dice la prefazione, per computazionalisti. Per quanto mi riguarda, posso ritenermi soddisfatto.
Iscriviti a:
Post (Atom)